Блог · 21 сентября 2026 г. · 8 мин
Структурированные логи и JSON: зачем перестать печатать просто строку
Почему свободный текст усложняет поиск и алерты, какие поля стоит стандартизировать и как это стыкуется с анализом в Logoric.
логирование,JSON,DevOps
Проблема «просто строки»
Когда приложение пишет User login failed for john, человек на экране что-то понимает. Для машины это непарсибельный шум: нет уровня, нет кода ошибки, нет корреляции с запросом.
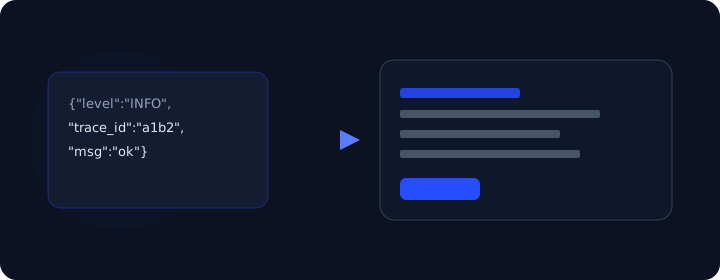
Структурированный лог — это запись в виде JSON (или key=value) с фиксированными полями: timestamp, level, service, message, плюс контекст: user_id, trace_id, http.status, error.code.
Минимальный контракт для сервиса
- Время в ISO-8601 UTC — иначе сортировка и «окна» по времени ломаются.
- Уровень — одна из согласованных меток:
DEBUG,INFO,WARN,ERROR(без «warn» и «WARN» вперемешку). - Идентификатор сервиса — совпадает с именем источника в платформе приёма (например
auth-api). - trace_id / request_id — один ID на цепочку вызовов между микросервисами.
Что даёт JSON на практике
- Фильтры
level=ERROR AND service=paymentбез regex. - Агрегации: сколько 5xx за 5 минут по
route. - Алерты по полю
http.status >= 500, а не по тексту «Internal Server Error».
Связь с Logoric
Платформа принимает JSON-полезную нагрузку и индексирует поля для поиска, паттернов и алертов. Чем стабильнее схема полей, тем проще строить правила и инциденты без ложных срабатываний.
Перейти к приёму логов и интеграциям: облачный сервис Logoric.
Ещё в рубрике «Логирование»
Тот же контекст — другие материалы.
Читайте также
Другие свежие материалы из блога.
Трассировка и микросервисы
Корреляция запросов: trace_id, request_id и сквозная диагностика
Как связать логи шлюза, микросервисов и БД одной цепочкой и почему без ID нет нормального MTTR.
8 мин · 21.09.2026
SRE, алерты и инциденты
Усталость от алертов: как снизить шум и не пропустить инцидент
Пороги, окна агрегации, подавление дублей и разделение «страница» vs «критичный сервис».
9 мин · 21.09.2026
SRE, алерты и инциденты
От алерта до постмортема: жизненный цикл инцидента
Триаж, эскалация, коммуникации, фиксация причин и что автоматизировать в первую очередь.
8 мин · 21.09.2026
Архитектура и платформы
ELK, Loki+Grafana или облачный SaaS: что выбрать для логов
Краткое сравнение по капексу, операционным затратам, закрытому периметру и скорости вывода в прод.
10 мин · 21.09.2026
Kubernetes и инфраструктура
Логи в Kubernetes: stdout, sidecar и агенты на ноде
Паттерны сбора, метки pod/namespace, ротация и что логировать при crash loop.
9 мин · 21.09.2026
Безопасность
PII и секреты в логах: маскирование до отправки
Что нельзя писать в открытом виде, маскирование токенов и ответственность команды владельца сервиса.
7 мин · 21.09.2026