Блог · 21 сентября 2026 г. · 8 мин
Три столпа observability: метрики, логи и трассы
Зачем нужны все три слоя, типичные антипаттерны и как не дублировать одно и то же в трёх системах.
observability,SRE,мониторинг
Зачем три слоя
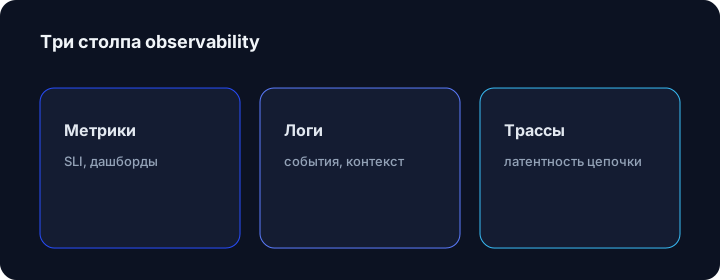
Метрики отвечают на вопросы «сколько за окно времени» и дают быстрые алерты по SLO. Логи — контекст события и причины ошибки. Трассы — где именно в цепочке выросла латентность.
Антипаттерны
- Логировать всё подряд «на всякий случай» вместо метрик по ключевым счётчикам.
- Пытаться восстановить распределённый граф только из логов без корреляции.
- Хранить огромные payload в логах там, где достаточно span-атрибутов.
Практика
Связывайте слои: один trace_id в логах, те же метки в метриках и трассах. Тогда инциденты быстрее переходят от «что горит» к «почему».
Logoric
Единая точка входа для логов и инцидентов с AI-поиском — Logoric.
Ещё в рубрике «Observability и AI»
Тот же контекст — другие материалы.
8 мин · 21.09.2026
Семантический поиск по логам: когда regex уже не спасает
Поиск по смыслу, похожие инциденты и как это сочетается с классическими фильтрами.
7 мин · 21.09.2026
Метрики и логи: единая картина без переключения десяти вкладок
Почему «одна панель» ускоряет MTTR, как организовать теги и что делать с дублированием данных.
Читайте также
Другие свежие материалы из блога.
Логирование
Структурированные логи и JSON: зачем перестать печатать просто строку
Почему свободный текст усложняет поиск и алерты, какие поля стоит стандартизировать и как это стыкуется с анализом в Logoric.
8 мин · 21.09.2026
Логирование
Уровни логов в продакшене: что не заливать в DEBUG
Политика уровней для команд, стоимость хранения и фильтрация шума до отправки в центральную систему.
7 мин · 21.09.2026
Трассировка и микросервисы
Корреляция запросов: trace_id, request_id и сквозная диагностика
Как связать логи шлюза, микросервисов и БД одной цепочкой и почему без ID нет нормального MTTR.
8 мин · 21.09.2026
SRE, алерты и инциденты
Усталость от алертов: как снизить шум и не пропустить инцидент
Пороги, окна агрегации, подавление дублей и разделение «страница» vs «критичный сервис».
9 мин · 21.09.2026
SRE, алерты и инциденты
От алерта до постмортема: жизненный цикл инцидента
Триаж, эскалация, коммуникации, фиксация причин и что автоматизировать в первую очередь.
8 мин · 21.09.2026
Архитектура и платформы
ELK, Loki+Grafana или облачный SaaS: что выбрать для логов
Краткое сравнение по капексу, операционным затратам, закрытому периметру и скорости вывода в прод.
10 мин · 21.09.2026